Quanto cada IA sabe de Direito brasileiro? Testamos quase 600 desafios jurídicos
Modelos caros nem sempre entregam os melhores resultados. Em nosso benchmark, o desempenho mudou conforme a área do Direito e, sobretudo, conforme as ferramentas disponíveis para o modelo.
Sempre que surge um novo modelo de inteligência artificial, precisamos decidir se vale incorporá-lo às soluções da Cognifyx. Para começar, fazemos uma pergunta: como ele lida com problemas do Direito brasileiro?
Criamos um benchmark próprio com quase 600 desafios jurídicos. Na seleção das questões, procuramos evitar perguntas que os modelos provavelmente já encontraram durante o treinamento, como as de provas da OAB. Avaliamos modelos em diferentes áreas do Direito e comparamos, em alguns casos, o desempenho do modelo puro com o resultado obtido ao usar o harness do Vibe Lawyer.
Os resultados mostram por que a escolha de uma IA jurídica não pode se resumir ao nome ou ao preço do modelo.
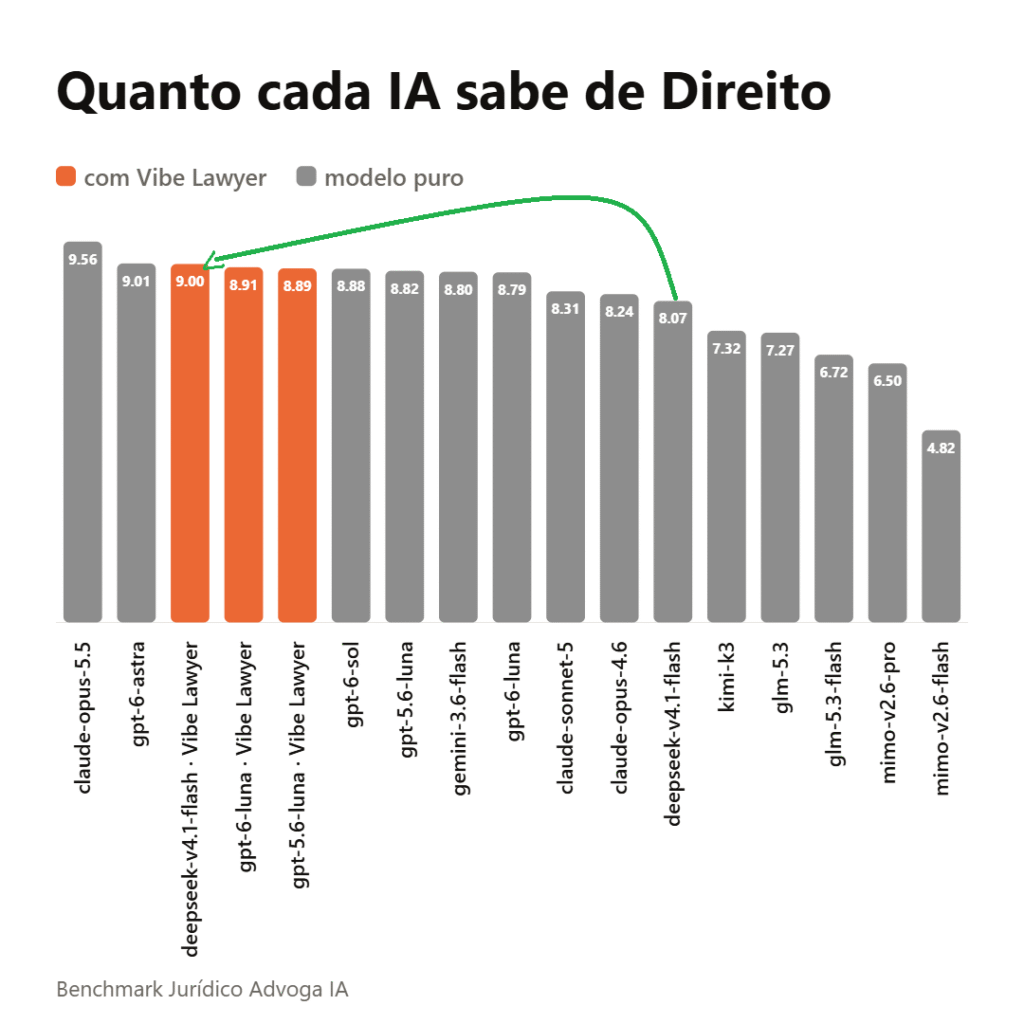
Notas do benchmark, em escala de 0 a 10. As barras laranja indicam configurações com Vibe Lawyer; as cinza, modelos puros.
1. O harness pode mudar o resultado
O caso mais marcante foi o DeepSeek V4.1 Flash. Sozinho, ele obteve 8,07 na nota geral. Com o harness do Vibe Lawyer, chegou a 9,00, praticamente no mesmo patamar do GPT-6 Astra, que marcou 9,01. Na comparação de preços por token que fizemos, o Astra custa 33 vezes mais na entrada e 42 vezes mais na saída.
O efeito também aparece em Direito Penal: o DeepSeek V4.1 Flash passou de 8,13, como modelo puro, para 9,20 com o Vibe Lawyer. Foi a maior nota da área, acima inclusive dos 9,13 do Claude Opus 5.5. Em Direito Empresarial e Tributário, a configuração com Vibe Lawyer ficou em segundo lugar, atrás apenas do Opus e à frente do Astra.
Isso não significa que o modelo sozinho tenha o mesmo conhecimento jurídico dos líderes. O resultado pertence ao conjunto formado por modelo, ferramentas e fluxo de trabalho. É justamente esse conjunto que importa quando avaliamos uma solução para uso real.
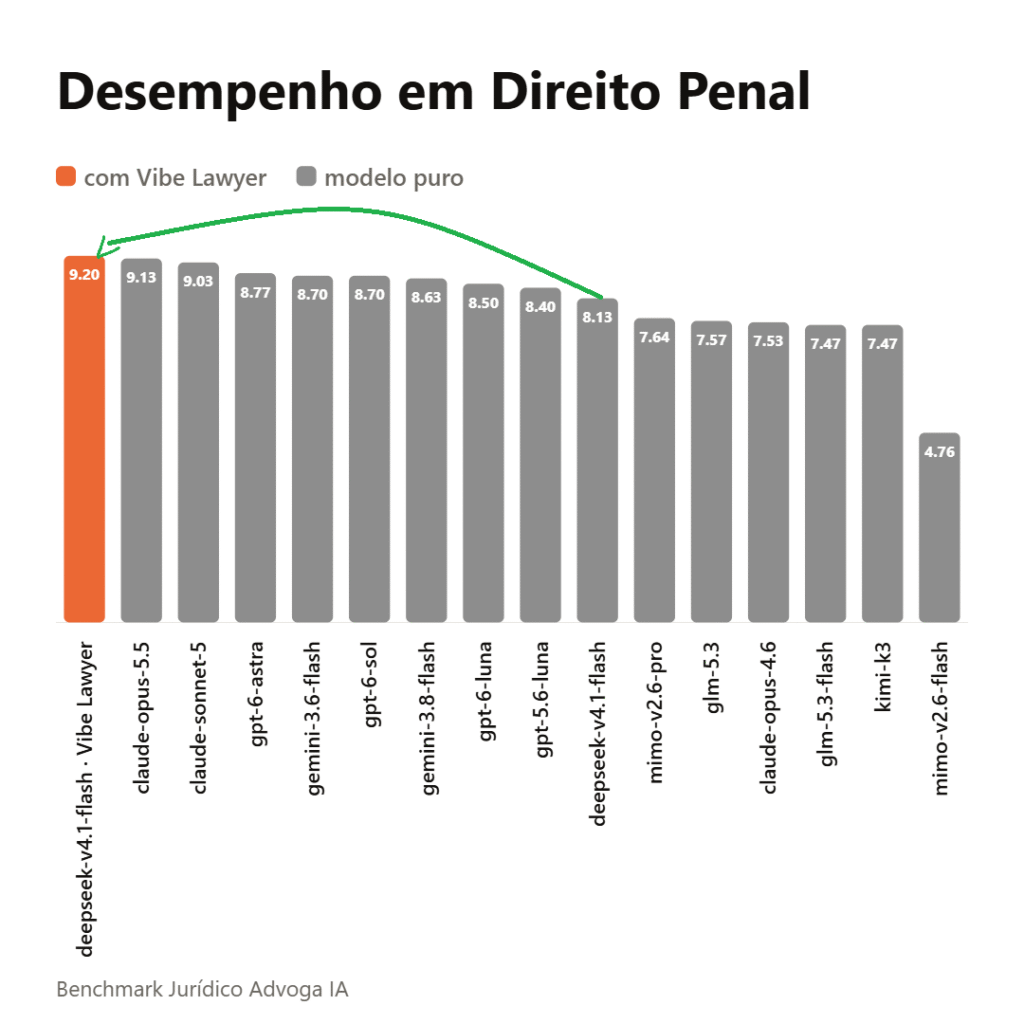
Em Direito Penal, o DeepSeek V4.1 Flash com Vibe Lawyer alcançou a maior nota da comparação.
2. Preço não é sinônimo de desempenho jurídico
O Claude Opus 4.6 ficou abaixo do GPT-6 Luna na nota geral. O Kimi K3, que se destaca em programação, ficou atrás do Gemini 3.6 Flash nesta avaliação jurídica. São exemplos de como a reputação de um modelo em outras tarefas não garante o mesmo resultado em Direito brasileiro.
O gráfico abaixo coloca a nota ao lado do preço de tabela por milhão de tokens informado para cada modelo. Preço por token e custo de resolver um desafio não são a mesma medida: o consumo de tokens pode variar conforme o modelo e a tarefa. Ainda assim, a comparação ajuda a identificar opções que merecem ser testadas antes de adotar sempre o modelo mais caro.
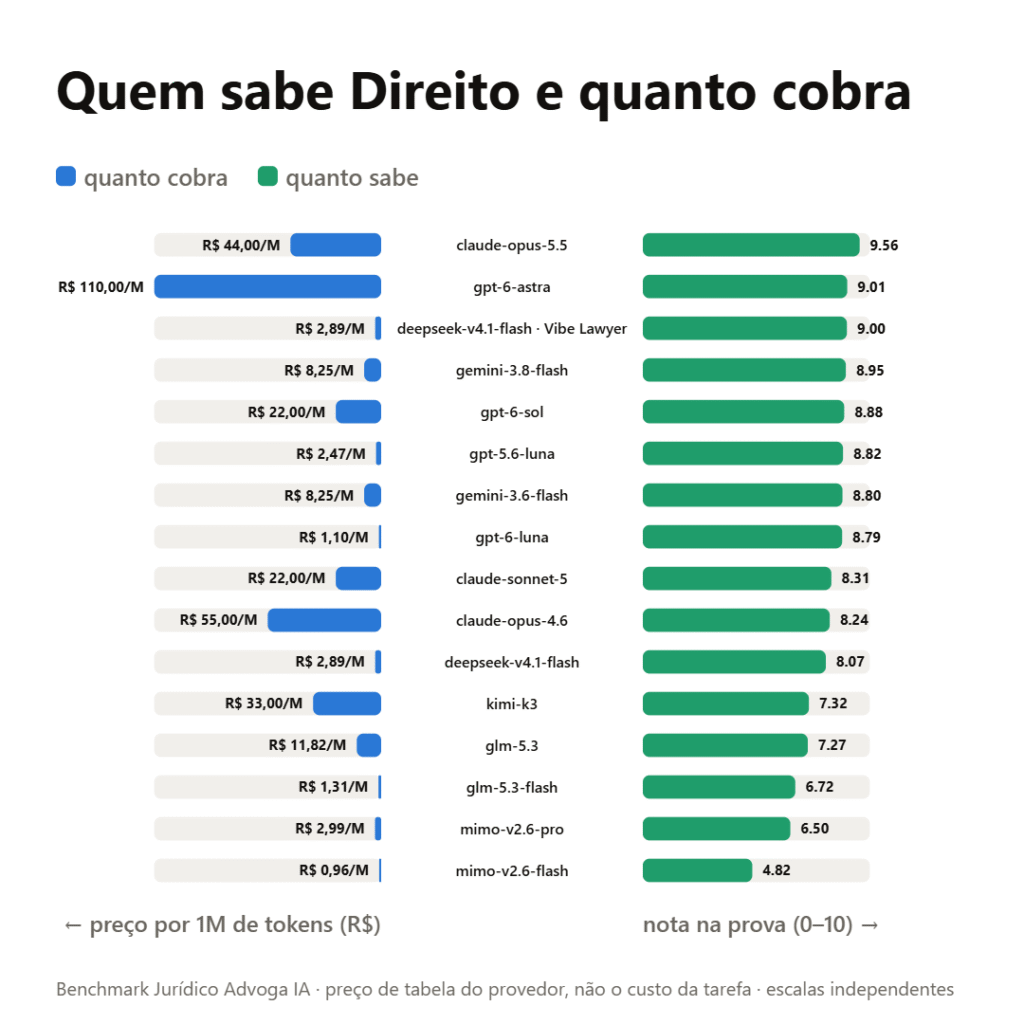
Os preços são os de tabela usados na comparação e podem mudar. As escalas de preço e nota são independentes.
Talvez diferenças na data de corte ou na composição dos dados de treinamento ajudem a explicar parte dos resultados. O benchmark não permite isolar essas causas.
3. Alguns modelos precisam de mais contexto e ferramentas
Sem o apoio de ferramentas adicionais, modelos da Xiaomi e da Z.ai estiveram entre os que mais apresentaram interpretações equivocadas e citações incorretas nos nossos testes. Uma hipótese é que tenham tido menor exposição a material jurídico brasileiro durante o treinamento. Não temos, porém, dados suficientes para afirmar que essa seja a causa.
Isso tampouco encerra sua utilidade em fluxos com agentes. O resultado do DeepSeek ilustra quanto uma configuração com ferramentas jurídicas pode alterar o desempenho; cada modelo precisa ser testado nessa configuração antes de tirarmos conclusões sobre seu potencial. Também observamos notas gerais próximas para GLM 5.3 e Kimi K3, mas a semelhança das notas não revela como foram treinados.
4. Objetividade e desempenho por área variam
Entre os modelos avaliados, o Gemini 3.8 Flash foi o mais objetivo nas tarefas jurídicas: apresentou menos sinais de raciocínio excessivo. Minha experiência com ele em programação é diferente, o que reforça a importância de avaliar o modelo na tarefa em que será usado.
As notas também mudaram bastante entre áreas. O Claude Opus 5.5 foi excepcional em Direito Tributário, mas não repetiu o mesmo resultado em Penal e Trabalhista. Em várias áreas avaliadas, o GPT-6 Luna superou o Astra e o Sol. Já Direito Empresarial pareceu impor uma dificuldade especial ao conjunto de modelos. A influência de dados norte-americanos no treinamento é uma explicação possível, mas o benchmark, por si só, não comprova essa hipótese.
O que esses resultados mudam na escolha de uma IA jurídica?
O custo e a qualidade precisam ser analisados juntos. No gráfico de nota por real gasto em cada desafio, modelos com notas próximas aparecem em posições muito diferentes no eixo de custo. O Vibe Lawyer com DeepSeek V4.1 Flash é um exemplo de configuração que combina uma nota alta com custo relativamente baixo na nossa comparação.
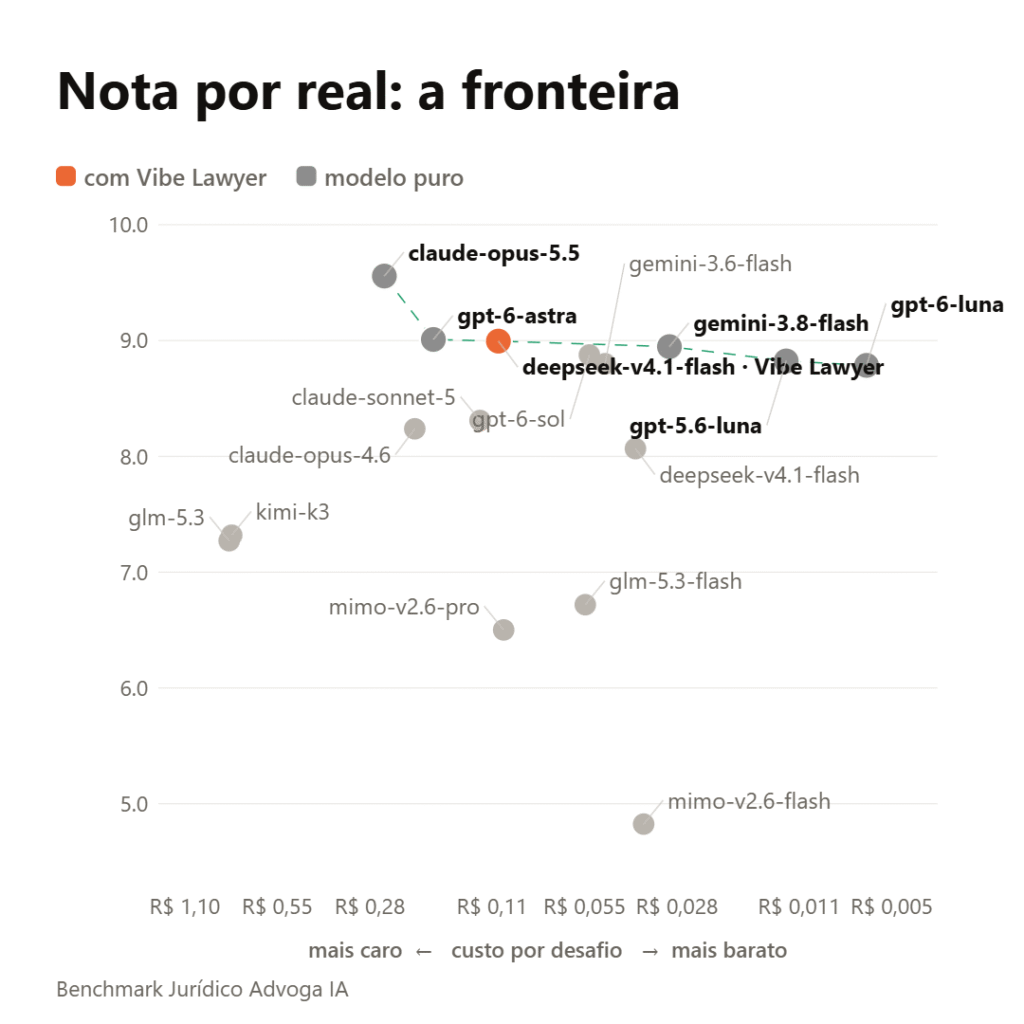
O eixo horizontal representa o custo por desafio no benchmark; o vertical, a nota obtida.
Como em qualquer benchmark, há limites. Uma nota superior em determinadas questões não significa que um modelo seja melhor em todas as tarefas jurídicas. Tampouco uma diferença pequena nas médias, sem análise de incerteza, prova superioridade consistente entre dois modelos.
O que os testes sugerem é uma estratégia mais cuidadosa: escolher o modelo conforme a área, a tarefa e as ferramentas disponíveis. Usar o modelo mais caro para tudo pode ser como dar um tiro de canhão em uma formiga. Em muitos casos, há caminhos para obter bons resultados por muito menos.
Na Cognifyx, é assim que avaliamos novos modelos para o Vibe Lawyer: medindo o que conseguem fazer em questões do Direito brasileiro e como seu desempenho muda quando trabalham com ferramentas jurídicas.